微软AI诊断系统复杂病例准确率83% 医生对照组仅36%
微软AI的医疗诊断系统交出了一份引人注目的成绩单:面对《新英格兰医学杂志》收录的复杂病例,其诊断准确率达到83%,而作为对照的基层医生和普通内科医生单独作答时只有36%。这项研究周四发表在《Science》(《科学》)杂志上,微软AI首席执行官穆斯塔法·苏莱曼(Mustafa Suleyman)把它称作迈向“医疗超级智能”的一步。
这套系统名为MAI-DxO,简称DxO,做法是调度多个AI智能体,像一支会诊小组那样工作:轮流追问病史、开具检查、就诊断结论互相辩论,而非让一个大模型直接给答案。微软主推的是一套把模型组织起来干活的方法,而非某个更强的模型。
数字的冲击力来自对比,但对照组值得细看:实验中的人类一方是基层医生与普通内科医生,他们单独工作,手边只有参考资料。真实医院里,这类复杂病例通常由专科医生或多学科团队接手,这些专家并未被纳入比较。
这就让“AI超过医生”的说法打了折扣。更准确的表述是:在一批疑难病例上,一套多智能体系统胜过单独作答的全科医生。这个结论本身仍有价值——基层医疗最缺的恰恰是专科判断力——但它不等于AI已经能替代专科团队。
另一个长期存在的疑问是训练数据。研究使用的病例来自已公开发表的医学文献,模型是否在训练中见过这些题目,外界很难完全排除。这种“考过的题再做一遍”的风险,是所有医学基准测试都要面对的麻烦。
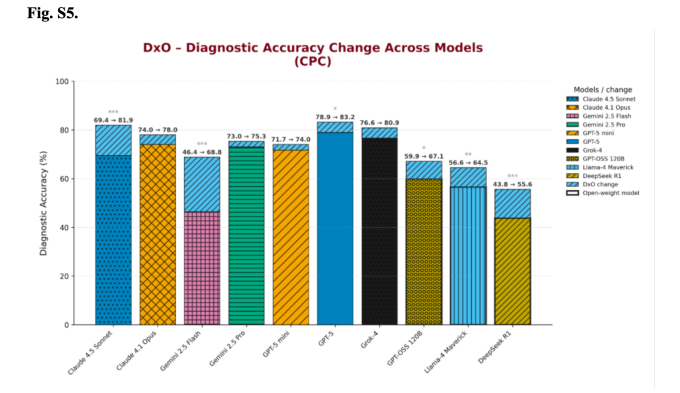
微软这次一并测了成本。单独使用GPT-5、只给简短提示时,复杂病例准确率为78.9%,单例估算成本约8400美元;加上DxO之后成本降了约3000美元,准确率只提高约4个百分点。
换句话说,AI诊断的成本账并不好看。即便省下3000美元,单例仍在5000美元以上,这个数字放在多数国家的医疗支付体系里都谈不上便宜,而它衡量的还只是推理开销,不含部署、验证与责任归属的成本。
急诊场景的表现更平淡。GPT-5单独使用与配合DxO,在准确率和成本上都没有明显差别,两者大致持平。
换上2026年4月发布的新模型GPT-5.5,结果出现分化:复杂病例上,DxO把准确率从72%拉到接近87%,成本还略低一些;急诊病例则再次原地踏步,用与不用都在85%左右。
不同厂商的模型也被拉进来做对照,包括OpenAI、谷歌、Anthropic、Meta和DeepSeek的产品,成绩最好的是OpenAI的GPT-5与GPT-5.5。能力较弱的模型受益更明显:Gemini 2.5 Flash单独作答只有46.4%,配上DxO后接近69%。
但即便在这样的组合里,弱模型与强模型之间的差距,仍然大于DxO带来的提升。微软研究人员的解释是,模型越接近理论天花板,编排能挤出的空间自然越小。这句话反过来读也成立:决定诊断水平上限的仍是底层模型,DxO是一层放大器,不是发动机。
苏莱曼对医疗AI并不陌生。他是DeepMind的联合创始人之一,该公司2014年被谷歌收购;次年,谷歌DeepMind收购了多米尼克·金(Dominic King)创办的临床任务管理应用Hark,两人随后共同推出DeepMind Health。金如今是微软AI健康业务副总裁。
那段经历算不上圆满:DeepMind Health后来被并入谷歌健康体系,面向临床医生的工具没能独立走完商业化路径。苏莱曼2024年加入微软执掌AI部门,金在几个月后跟进——对两人来说,DxO更像是同一条路上的第二次尝试。
苏莱曼给出的时间表相当激进。微软正与梅奥诊所合作训练一个医疗基础模型,计划明年发布;他认为医疗模型的能力“在未来24到36个月内会好上一个数量级”。他给出了更具体的场景:2027年前后,病历有望迎来类似编程领域的突破,系统可以流式给出对病情走向的高精度预测。
模拟成绩之后,真正的考验在医院。微软与波士顿贝斯以色列女执事医疗中心(Beth Israel Deaconess Medical Center)达成合作,将在不同医院环境中评估DxO的临床推理能力。
按照金的描述,患者照常接受分诊、专科诊疗、检查与出院判断,同意参与的人会同步与DxO交互,研究团队再把AI的建议与人类医生的处置逐条比对。他称这将是同类研究中规模最大的一项。
竞争对手没有闲着。谷歌本月刚与同一家医疗中心在《柳叶刀》上发表了AMIE对话式诊断AI在真实急诊场景的临床研究,人类医生全程实时监督。谷歌与OpenAI此前都已公开宣称自家模型在诊断上可与医生匹敌,微软这次带着《Science》论文入场,争的是同一块招牌。
商业上的算盘也不难看清。微软已经在向临床医生销售语音听写与影像工具,DxO被定位为这条产品线的延伸。苏莱曼的表态很直接:未来几年必须拿出最顶尖的临床决策支持产品。医疗是少数客户愿意为准确性付高价的行业,也是监管最严、出错代价最大的行业,这两点同时成立,才让各家实验室在这里反复加注。
回到那份83%。它证明多智能体编排这条路能走通一段,也暴露出它对强模型与算力成本的依赖,以及病例集尚未经过真实门诊检验的软肋。苏莱曼说的“飞轮”,要转起来得先有医院愿意把病人的真实决策放进去对照。波士顿那项研究的结果,比任何基准分数都更能说明问题。
 手机网游
 手游单机