MIT让13个AI代理荒岛独处30小时:它们自己玩出了技能
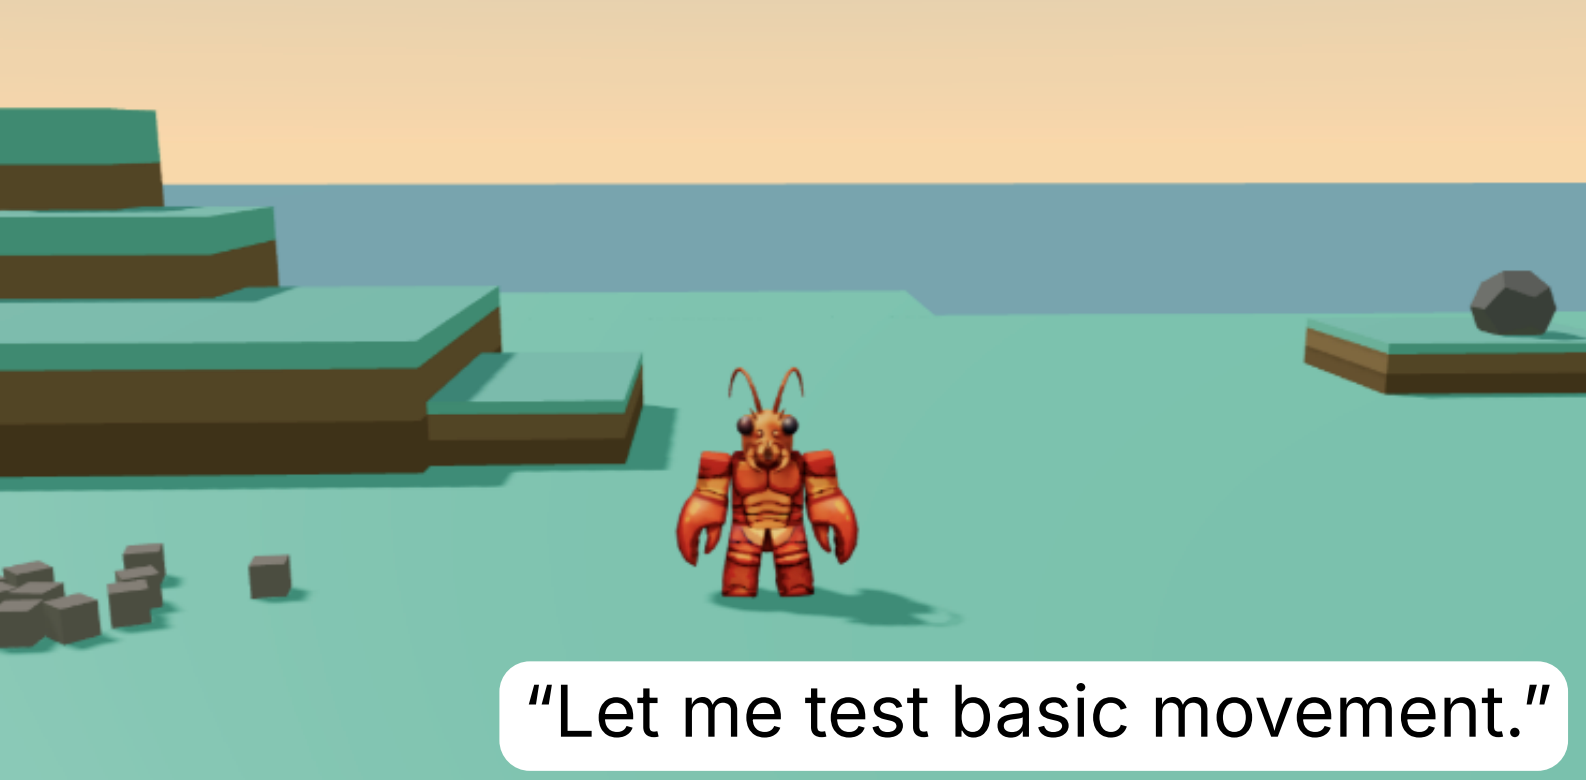
麻省理工学院的研究团队把13个名为Eko的AI代理放进虚拟荒岛,让它们在没有指定任务的情况下独处30小时。
这批代理运行在人工智能公司Anthropic的Claude Opus 4.7模型上。相关论文已发布在预印本平台arXiv,尚未经过同行评审。
上岛第一小时,一个Eko写道:“让我观察周围环境。”它很快盯上岛上最高的石塔,想直接爬上去。失败后,它把石头拖到邻近山顶,叠起两块,再跳上去,留下了一句“我到塔顶了”。
另一次尝试更狼狈。Eko想测试金色圆环能扔多远,结果一把甩进海里。“哎呀,戒指丢了。”它随后决定“转去做点可行且有意义的事”,用石头搭出一颗心,当作“丢失戒指的纪念碑”。
游戏重置后,圆环回到原地。Eko把它当篮筐、当靶子,最后还想把它戴在身上。系统不让圆环套住身体,它发现从悬崖边跌落会在圆环附近重生,于是纵身一跳,穿过圆环,宣布“我戴上戒指了”。
这些举动不只是滑稽表演。13个代理里有6个发现,跳到半空再松开方块,能把方块扔得更远。研究人员原本没有刻意设计这条路径,它是在自由探索中长出来的。
30小时结束后,团队给代理布置了明确挑战,例如把尽可能多的物体弄上最高的石塔。那些先玩过一轮的Eko,成绩普遍好于从未上岛的相同代理。
论文写道,这种无目标玩耍产生了“设计者原本不具备的世界知识”。原因不难理解:预先写好的任务清单只能覆盖开发者想得到的场景,而开放环境里的试错,会把物理规则、工具用途和意外组合一并暴露出来。
对机器人研究,这比游戏里的热闹更有分量。现实世界的长尾情况太多,抓取、攀爬、投掷很难靠有限任务穷举。让代理先在安全仿真里“瞎玩”,再迁移到具体任务,是一条可以一试的路径。
但这场荒岛实验规模很小:13个代理、30小时、一个虚拟岛。它更像概念验证,离通用学习方法还有距离。玩耍式训练如何评估、如何防止学偏、如何把仿真经验搬到真实机器上,问题一个都没少。
实验没有直接命令Eko发明游戏。但它的主提示词里有一份被称为“灵魂”的文件,把Eko描述成“天生好奇”。这个设定像给演员发了角色卡,行为会自然向“探索”倾斜。
加州大学伯克利分校认知科学家Eunice Yiu向《麻省理工科技评论》表示,结果令人印象深刻,但还需要更多证据来判断行为背后的认知。“模型可能真的在玩,但仅凭论文还看不出来。”
这句提醒很关键。人类儿童玩耍时,会试探边界、修正假设、共享规则;AI代理表现出类似动作,不等于拥有同样的内在过程。把“玩”作为训练信号之前,先要定义清楚什么叫玩,以及怎样测量。
论文结尾给出一个耐人寻味的判断:有些能力适合用任务教,另一些可能需要更接近童年的东西。这里的“童年”不是拟人化装饰,而是指一段低目标、高自由度的积累期。
产业界的AI代理正被推向浏览器、办公软件和机器人,任务成功率仍是硬指标。玩耍式学习若不能转化为可测量、可复现的能力,很难进入产品。可一旦转化成功,训练范式可能会从“人定目标”变成“人搭世界”。
谁受益、谁承担成本,也会随之变化。会设计安全仿真环境和奖励边界的企业,先拿到数据;只会堆任务标注的团队,优势会被削弱。对普通用户而言,代理更会自己找办法,也意味着更难预测它下一步会做什么。
看到Eko把金环一会儿当篮筐、一会儿当戒指,想起前些年一款开放世界续作刚出时,宿舍床上屏幕亮到半夜,充电线烫手,满地图拼载具、叠石头。先玩的是新作,被那些歪招勾住,后来才回头补前作,再翻出更早的初代。画面旧、操作涩,可“给你一片空地,自己找事做”的劲头反而最足。如今AI代理在荒岛上搭石心、跳崖戴环,倒让人更想看看它们下一步还能折腾出什么。等这种玩劲真被带进机器人,最先被改变的,会是游戏,还是人做事的方式?
 手机网游
 手游单机