Canva首款自研图像生成模型Craft上线,文字清晰还能分层改
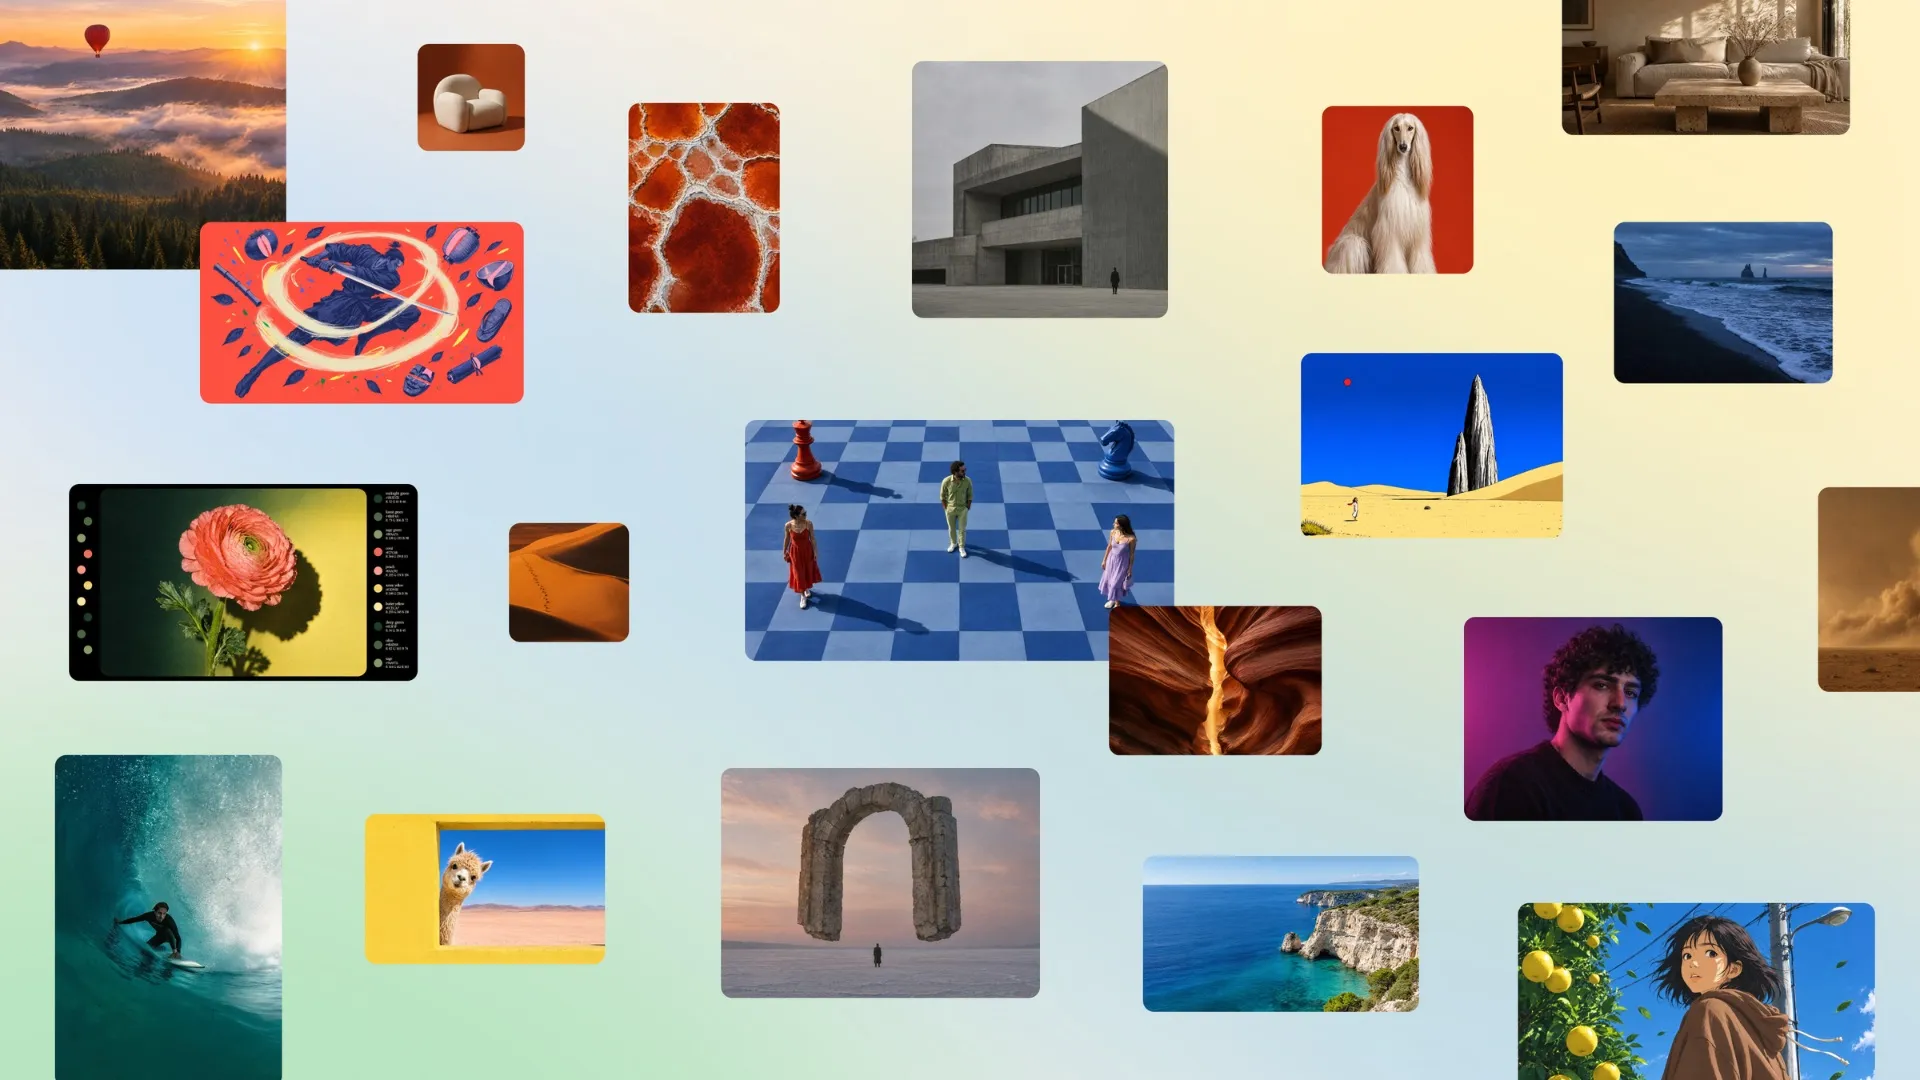
设计平台Canva发布了其首款自研图像生成模型Canva Craft。该模型由公司内部研究团队开发,直接对标谷歌、OpenAI、字节跳动和Meta的同类产品,目前已向平台所有用户开放,入口位于Dream Lab标签页。
与常见的“一句话出图”不同,Canva Craft把生成拆成两步。第一步理解用户提示词,先列出一份画面计划,写明各元素的空间关系、相对大小、视觉层级,以及后续要渲染的文字内容;第二步才按计划输出图像。
按Canva的说法,这套流程让画面中的物体细节更准确,文字也能保持清楚可读。用户可以对局部做精确修改,而不牵动图像的其他区域。输出规格上,模型支持最高2K分辨率和约30种宽高比。
训练数据的选择是这款模型比较特别的地方。Canva没有用照片喂给模型,而是调用了素材库中由人类设计师制作的模板,涵盖海报、社交帖、信息图、菜单和排版密集的版式。
这样训练出来的结果,可以直接接上Canva Magic,把生成的图转成带图层的设计文件。Canva去年曾发布过一款能理解设计与图层结构的模型,两者配合之后,生成图像不再是终点,而成了设计流程的中间环节。
这背后是设计工具角色的变化。过去这类平台卖的是模板和拖拽体验,用户要自己找素材、调间距、对齐网格;生成模型把从零到一的门槛压到一句话。
可真正决定作品能不能交付的,仍是文字对不对、图层能不能改、尺寸合不合平台要求。Canva Craft把力气花在这几点上,说明它想抢的不是艺术创作,而是日常的商业物料。
商业上的账也算得清楚。Canva平台此前接入了多家外部图像模型,每次调用都要付出API费用。换成自家的模型,成本结构会变,质量和速度的调度权也回到自己手里。
公司还透露正在开发Craftfast和Craft-ultrafast两个更便宜的版本,近期推出。这并非Canva第一次在生成式AI上落子,2024年它收购了媒体生成平台Leonardo.ai,Leonardo的研究人员参与了此次新模型的开发。
竞争环境不算轻松。谷歌、OpenAI、字节跳动、Meta都在迭代图像模型,Adobe则把Firefly嵌进自家的创意软件产品线。Canva的差异在于设计与协作场景本身:用户生成图片,往往是为了放进一份演示、一张海报或一条社交内容。
财务层面则有些微妙。Canva此前预计年营收达到40亿美元规模,但公司下调了2026年的增长预期,有外部分析师估算其估值从420亿美元滑落至350亿美元。一边是新品密集发布,一边是增长放缓。
接入范围还在往外扩。Canva计划通过MCP协议,允许ChatGPT、Gemini等第三方助手调用其图像生成能力,同时开放Canva API,让开发者把生成能力搬进自己的工作流。
用户端的感受会更直接。普通用户最明显的变化,是生成的字终于能看了;设计师要面对的局面不太一样:重复性的排版和配图会被压缩,把控方向、审校文字、组织信息的能力反而更值钱。
社团招新前一周,宿舍桌上摊着几张打废的样张,屏幕里海报标题怎么调都发虚,图层叠了十几层,导出的进度条爬得人心焦。要一张能用的图,得先翻素材站、再抠图、再一格一格对齐,一晚上过去,眼睛干得发涩。如今在Dream Lab里敲一句“招新海报,蓝白色调,标题要清楚”,出来就是2K,比例随便挑,字还真读得清。头一回看见生成的字不歪不糊,愣了几秒——原来做图可以是这样的。唉,当年那些熬夜对齐的格子,算是白熬了。
图像生成的门槛已经很低,难的是生成之后还能继续改。Canva Craft押注的正是这段被多数模型略过的路,能不能走通,要看用户愿不愿意为一张“能改的图”留在Canva里。
 手机网游
 手游单机