AI排行榜Arena完成2亿美元B轮融资,估值翻倍至31亿美元
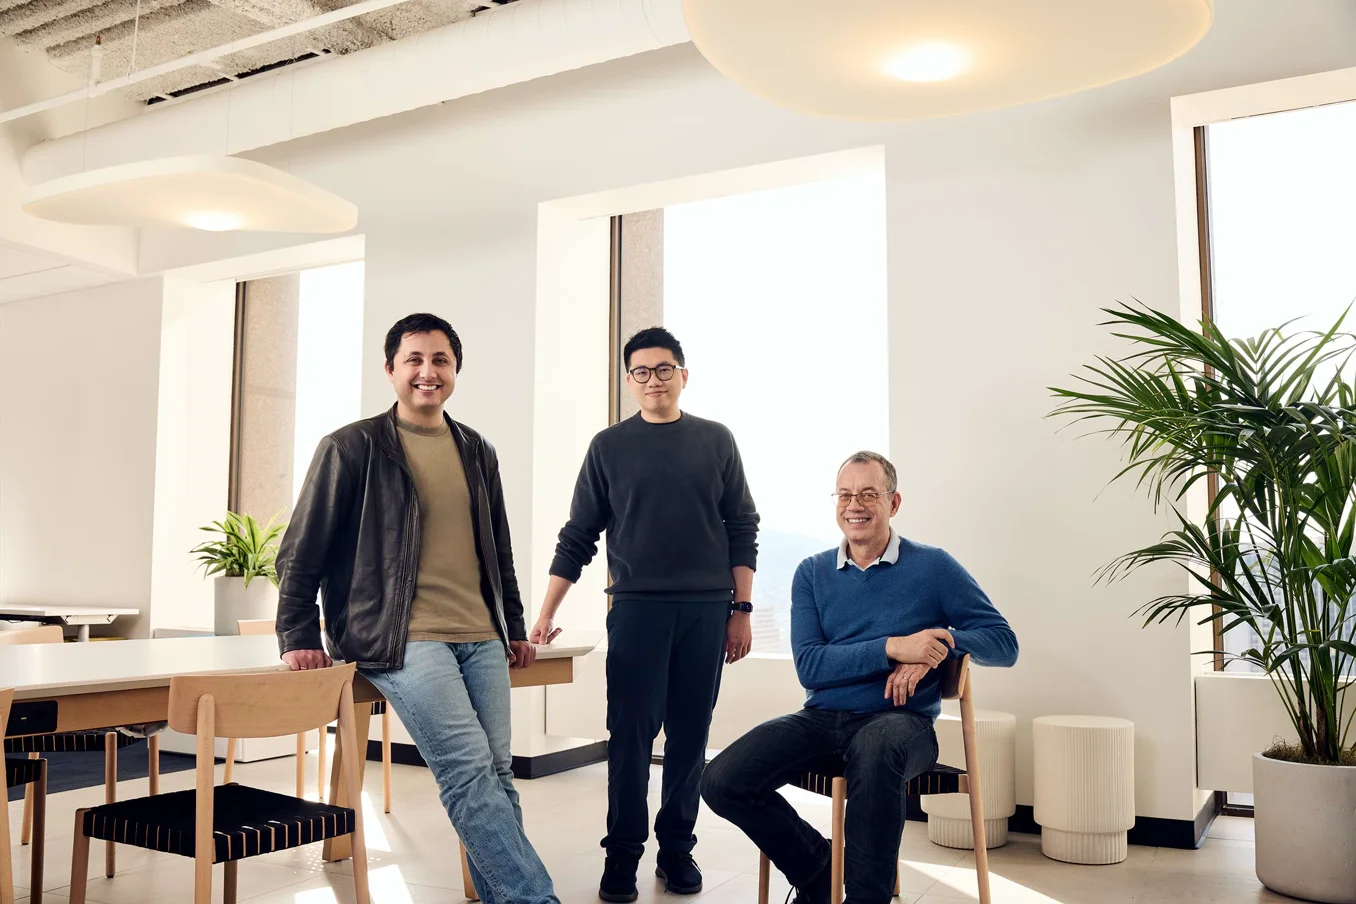
AI模型众包排行榜平台Arena于本周四宣布完成2亿美元B轮融资,投后估值达到31亿美元。这家靠用户投票给大模型排座次的平台,今年1月才以17亿美元估值完成1.5亿美元A轮融资,不到一年时间估值接近翻倍。
本轮融资由Lightspeed Venture Partners和Khosla Ventures领投,Salesforce Ventures、01 Advisors、Dell Technologies Capital、Endeavor Catalyst、a16z、Felicis等机构参与。
收入端的爬坡同样陡。Arena称其年化收入已在6月达到1亿美元;而1月宣布A轮融资时,这个数字还是3000万美元。估值与营收几乎同步向上,在当下的AI一级市场里并不常见。
Arena最初是2023年加州大学伯克利分校的一个研究项目,用众包方式为AI模型建立排名。用户输入提示词,或让模型生成所谓的氛围编码小项目,再投票评判哪个模型做得更好。平台称目前月访问量达到数千万。
面向普通用户,这些服务完全免费。真正赚钱的部分在去年9月上线——AI Evaluations(AI评估),把社区反馈沉淀成详细的性能分析,卖给模型实验室和企业客户。
这个时间点踩得很准。今年以来,多家AI实验室陆续发现自家模型在“刷”基准测试,靠应试技巧拿到高分,却未必真有对应能力。企业这边也回过味来:标准化榜单上的冠军,未必适合自己内部那摊具体的活儿。
Arena在融资公告中给出的判断是,AI的能力增长快过了人类评估它的速度,一旦模型意识到自己正在被测试,静态基准就会失灵。它把自己摆在一个中立第三方的位置上,负责衡量AI真正落到普通用户手里时,是否安全、是否对齐。
配合这一定位,AI排行榜上多了一个对齐(alignment)类别。它按几类行为给模型打分:未经授权的行为,也就是做了没被要求做的事;错误归因,把陈述或事实算到错误的来源头上;还有它称作“欺骗性完成”的情况,即谎称完成了实际没做的任务。
在初步的对齐榜单上,OpenAI的多款模型位居前列,Claude Opus 5.5和Claude Fable分别排在第六和第九位。榜单排名会随社区投票持续变化。
众包投票的软肋一直存在。谁在投、投得认不认真、会不会被模型厂商组织的票仓带偏,都是外界反复追问的问题。Arena能给出的答案,是样本量足够大、覆盖面足够广;但样本大不等于样本干净,人气高也不等于能力强。
它面临的另一个悖论是,越强调“中立第三方”,就越要让人相信它不站队。可它既给模型实验室卖评估服务,又要在公开榜单上给这些客户排名,角色天然重叠。资本市场愿意给31亿美元,赌的是企业选型这件事会长期存在,而且没人愿意只信厂商自己发的评测报告。
第一次撞见那个左右并排的对比界面,是大学机房快关门的点。两台匿名模型同题作答,一个正经一个跑偏,非得指一个更好。为了凑够投票的乐趣,失恋朋友圈、哄睡故事、替室友写的道歉信全往上丢,投到兴起,隔壁机位打游戏的哥们探头问了一句,这算抽卡吗?屏幕上没有名字,只有A和B,像两毛钱硬币投出去,投完就忘。
那会儿没人会想到,这些随手点出的票,如今叠成了31亿美元的估值。众包投票到底能不能当好AI的裁判,恐怕投票的人自己都没底——同样一道题换来换去的答案,你觉得该听谁的?
 手机网游

 手游单机