联合国联手谷歌改造全球统计平台,让数据可供AI智能体调用
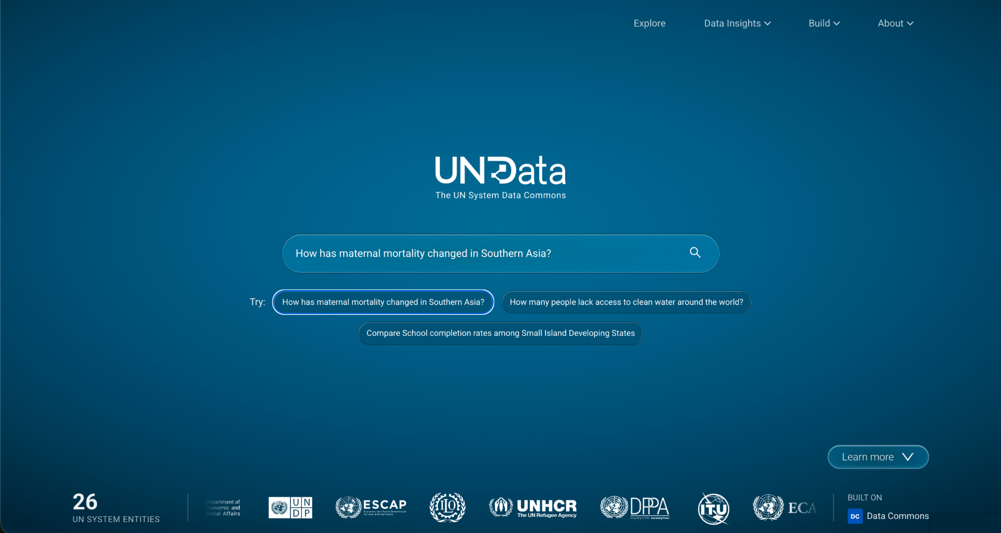
联合国宣布与谷歌合作,把庞大的全球统计数据改造成AI系统可以直接读取、使用的形态。新平台名为UN System Data Commons,建立在谷歌开源项目Data Commons之上。
它接替了原有的UNData门户。过去用户要在联合国各机构之间逐个翻找数据库,现在一句自然语言查询,就能调取跨机构的统计数字。
联合国表示,26个下属实体已承诺接入该平台,上线时约20个机构的数据可供查询,各机构数据首次被放进同一套检索入口。
联合国统计司代理司长沙塔努·穆克吉说,新系统在规模、范围和灵活性上“高出好几个量级”,首次把联合国系统内如此多的机构连在一起,也借这个机会让统计资料达到“AI就绪”的状态。
联合国急着给数据做AI适配,与AI给出的答案有多不靠谱直接相关。联合国儿童基金会首席统计师若昂·佩德罗·阿泽维多在线上吹风会上公布了一项基准测试结果。
测试覆盖六款大语言模型、超过13.3万条关于全球发展指标的问答,平均准确率只有21.2%。
参测模型包括OpenAI的GPT-4o与GPT-4o-mini、Anthropic的Claude Sonnet 4.5与Haiku 4.5,以及谷歌的Gemini 2.5 Flash与Gemini 2.0 Flash。
约五分之三的回答没有给出可用的数字,多数情况是模型含糊其辞。稳定性同样成问题:同一批问题隔两天再用相同版本模型问一遍,两次都给出数字的回答里,只有约一半前后一致。
这份测试是儿基会正在准备投稿的工作论文,尚未经过同行评审,机构称将与论文一起公布方法、代码和数据。
新平台支持Model Context Protocol(模型上下文协议,一种让AI系统直连外部数据源的接口规范),AI智能体可以按标准方式查询统计数字及其来源。这一协议由Anthropic提出,谷歌在去年已为Data Commons加入相应支持。
每条统计数据都附有来源记录,用户能顺着AI给出的回答,一路追溯到联合国的原始出处。阿泽维多对记者说,在越来越多人依赖AI工具查找和解读信息的时候,这一点很重要。
谷歌演示了一个场景:让接入平台数据的AI分析美国总统艾滋病紧急救援计划在非洲的影响。系统自行找出了艾滋病感染、艾滋病死亡率、预期寿命等指标,并据此生成信息图。
谷歌Data Commons团队负责人普雷姆·拉马斯瓦米提醒,把权威数据交给AI,并不等于它的结论就权威。“模型可能误读细节,在引用或发布前,应当始终由人来复核输出结果。”
谷歌旗下的Google.org投入200万美元能力建设资金和技术支持,帮助搭建平台核心基础设施。Data Commons项目启动于2018年,初衷是把不同来源的公共数据整理进同一套框架。
这笔投入的回报不在账面。谁先让权威数据以自己定义的方式被AI读取,谁就在“AI引用什么”这件事上占到先手。谷歌用开源平台换取生态位置,联合国拿到基础设施,双方各有算盘。
按照联合国统计司的设想,到2027年,联合国系统80%的统计数据要搬上这个平台。平台托管在联合国治理的实例上,谷歌称最终目标是让联合国独立维护、运营和扩展,并以“培训培训者”的方式完成交接。
另一层考量是入口。儿基会的数据网站每月访问量超过600万,是该机构最受欢迎的站点之一。
今年1月1日至9月14日,从ChatGPT回答中的链接跳转而来的访问同比增长67%,占全部会话的6.4%;儿基会估算,各类AI助手合计贡献约十分之一的访问量。当提问的习惯被交给AI,机构若不出现在AI的答案里,几乎等于不存在。
问题在于谁来兜底。联合国把数据整理好交给机器,管不了机器怎么转述;谷歌提供工具,也不为输出结论负责。核查的成本,最后还是落在写报告、做报道、拍板决策的人身上。
高中某个暑假,社会实践作业要做一份关于发展中国家儿童健康的小报告。镇上那家网吧一小时好像两块多钱,风扇嗡嗡响,屏幕右下角的弹窗关都关不完。为了凑一个婴儿死亡率,翻了几十个网页,最后抄下来的表格连出处都没标,抄完心里发虚,也只能硬着头皮交上去。如今对着AI问一句,几秒钟连图表带分析都摆在眼前,效率高了何止一个档次——只是隔两天再问一遍,那个数字说不定就换了个样。
 手机网游

 手游单机