高通发布骁龙8 Elite Gen 6双芯,端侧AI可跑300亿参数模型
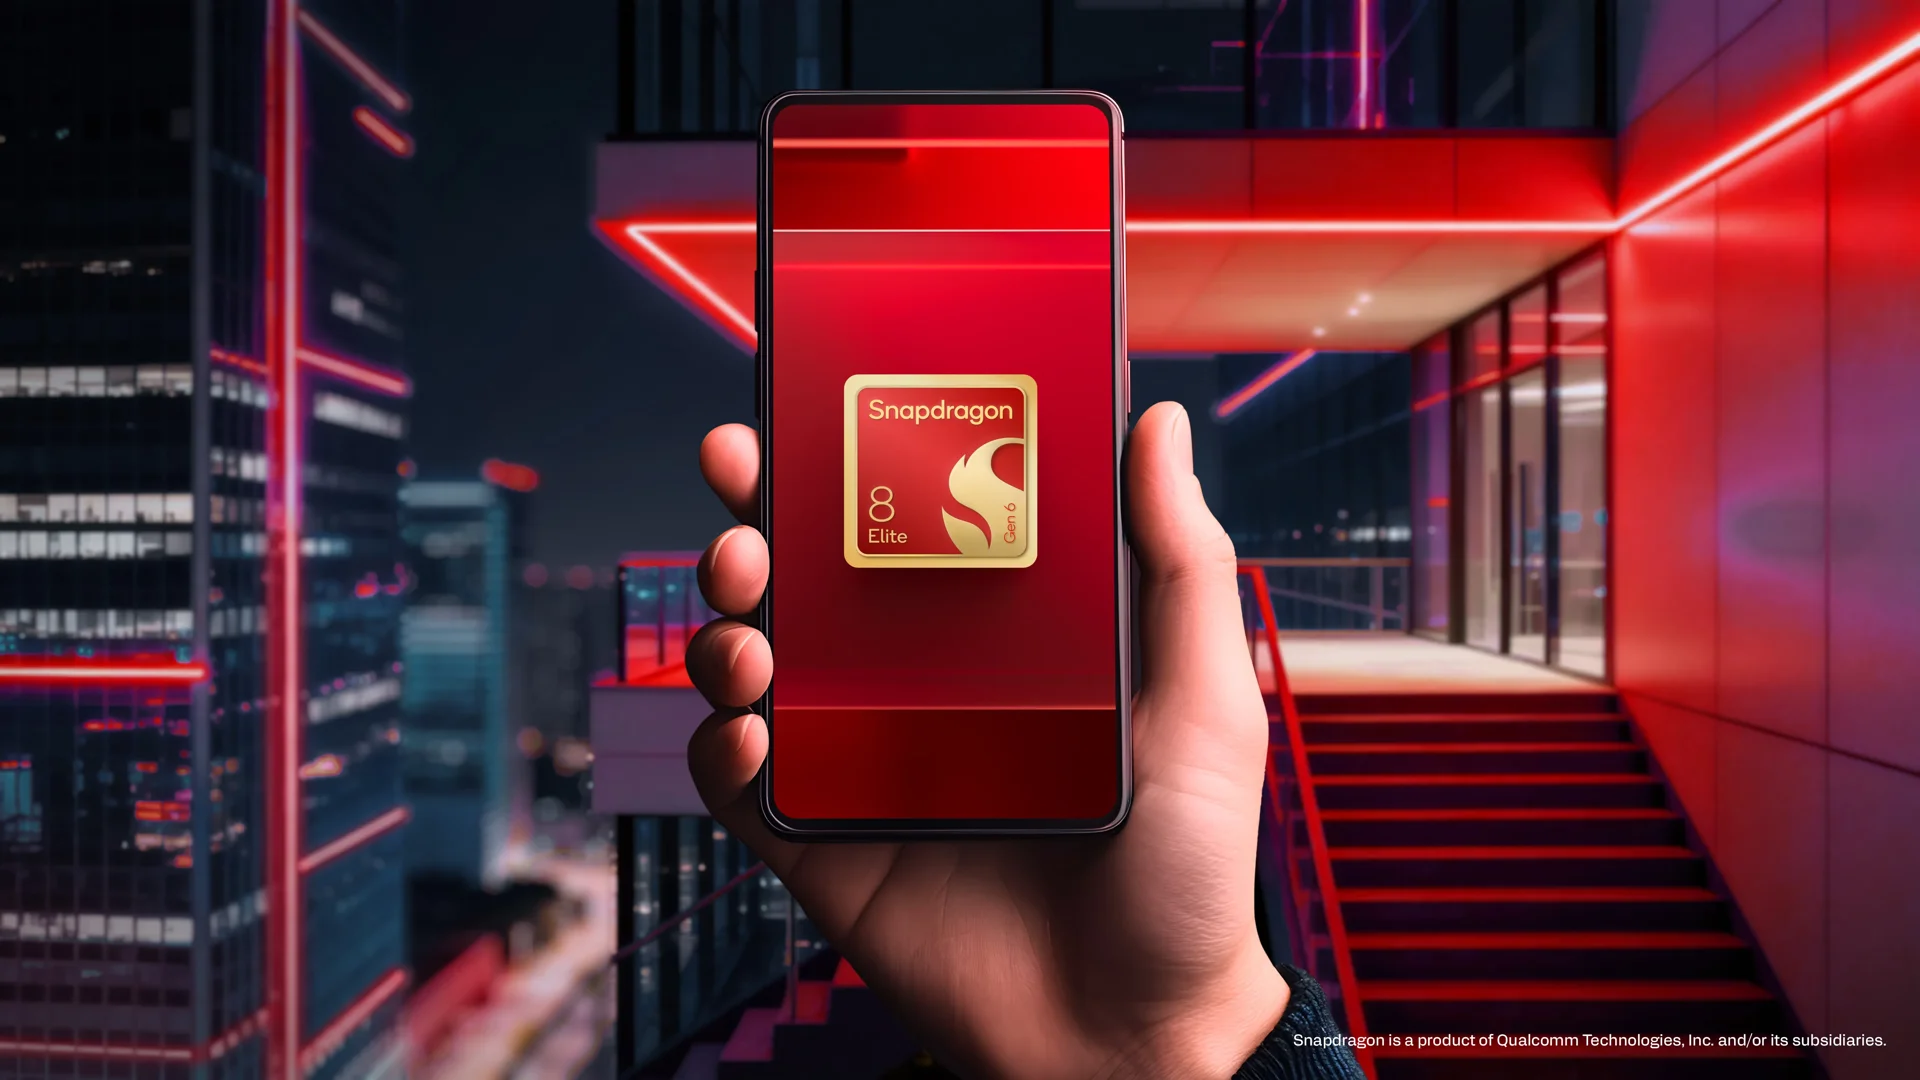
高通9月23日在年度骁龙峰会上推出两款旗舰手机处理器——骁龙8 Elite Gen 6与骁龙8 Elite Extreme Gen 6,两条产品线都把重心压在端侧AI上。顶配Extreme版本可在手机本地运行300亿参数的混合专家(MoE)模型。
两款芯片都配备新的传感中枢,可运行最高2亿参数的小模型。手机据此能在本地完成个人速记、区分不同说话人,并依据使用习惯积累记忆,让自动化任务的建议更贴合用户。高通称,新芯片能完整跑通语音输入到语音输出的代理流程。
骁龙8 Elite Gen 6新增加速器元件,以更高效率运行模型。Extreme版本可本地跑通300亿参数MoE模型:模型整体规模为300亿,但针对具体任务只激活其中一部分参数,以此压低算力与功耗开销。
高通把这一规格与苹果直接对照。苹果6月在WWDC(全球开发者大会)上发布200亿参数的混合专家模型,是其第三代基础模型中最先进的一款。按双方公布的参数规模,高通Extreme版本的本地模型高出约五成。
影像层面,新CPU让摄像头实现像素级控制,拍摄体验更接近专业设备,防抖与运动识别同步改善。Extreme版本支持8K 60fps录制和4K 240fps超高清慢动作,并启用新的高级专业视频(APV)编解码器。
两款芯片都能借助AI增强人声、降低噪声,并搭载高通新的voice bubble技术,在通话中隔离用户周围的杂音。
终端落地方面,摩托罗拉在峰会上宣布Motorola Signature 27手机,由骁龙8 Elite Extreme Gen 6驱动,将在今年内正式开售。
高通已在40多款AI设备上投入资源,公司仍认为多数人会优先用手机而非专用硬件接触AI。Nothing联合创始人Carl Pei此前暗示过这一趋势,苹果新CEO John Ternus本月早些时候在iPhone Duo发布会上也表达了相近看法。
手机里装大模型并不新鲜,但参数规模推到300亿,性质就不同了。此前端侧模型普遍停留在数十亿参数级别,主要处理摘要、翻译和简单问答。跨过百亿门槛后,手机才有条件承接更复杂的推理任务。
MoE架构是其中的关键。它把模型拆成多组专家,每次推理只调用相关部分,在参数总量与算力开销间取得平衡。高通的300亿模型、苹果的200亿模型都走这条路,端侧AI的比拼已从堆参数转向能效与体验的权衡。
普通用户能感知到的端侧AI价值,集中在隐私与响应速度。数据留在本地,不必上传云端,语音助手、照片处理、实时翻译都能离线运行。用户对数据外传的顾虑,正在被厂商转化为产品卖点。
参数规模与日常体验之间不能直接画等号。手机端高频的AI功能,仍是通话降噪、照片修图、语音转写这类轻量任务。300亿参数模型能否被用户真切感知,要看自动化任务和个性化代理能否做得顺手,而不只是发布会上的演示。
高通一边升级手机芯片,一边在40多款AI设备上布局。过去两年,专用AI硬件屡有尝试,多数产品的实用性和留存都不理想,手机则始终是用户每天握在手里的计算平台。把AI叠加上去,商业风险远低于另起炉灶。
对芯片厂商来说,考验还在后面。本地运行300亿参数模型,对内存、散热和功耗管理都提出更高要求,这些指标要到量产机型上市才能验证。摩托罗拉Signature 27是首个公开落点,实际表现会比峰会上的参数表更能说明问题。
 手机网游


 手游单机