Elorian发布首个AI模型Glimpse 让图像推理反复“回看”源头
帕洛阿尔托AI初创公司Elorian在周五发布首个模型Glimpse。这家公司尚无产品时便以3亿美元估值融到5500万美元种子轮,如今交出第一份作业。Glimpse以研究预览形式上线,开放API调用,聊天界面需排队等待。
Elorian要回答的问题很直接:今天的模型写代码、写文章都行,却始终算不上真正“看见”了图像。多数多模态模型只是把图像一次性转成token,随后在文本层面推理,像凭记忆描述一张照片。
Glimpse的差别在于它会不断回到画面本身。推理到一半,模型可以裁切某个区域、从视频里抽出关键帧,或者直接运行代码去测量和比较眼前的像素。Elorian把这套机制称为视觉草稿空间。
打个比方,就像在手机相册里双指放大,确认刚才到底看见了什么。图像不再是读一遍就扔掉的输入,而是可以随时翻回去查证的底稿。
这条路并非无人走过。OpenAI在2025年就给o系列模型加过推理中的裁切与缩放。Elorian的不同在于,它把整个模型围绕这一机制来设计,而不是当作外挂能力补上去。
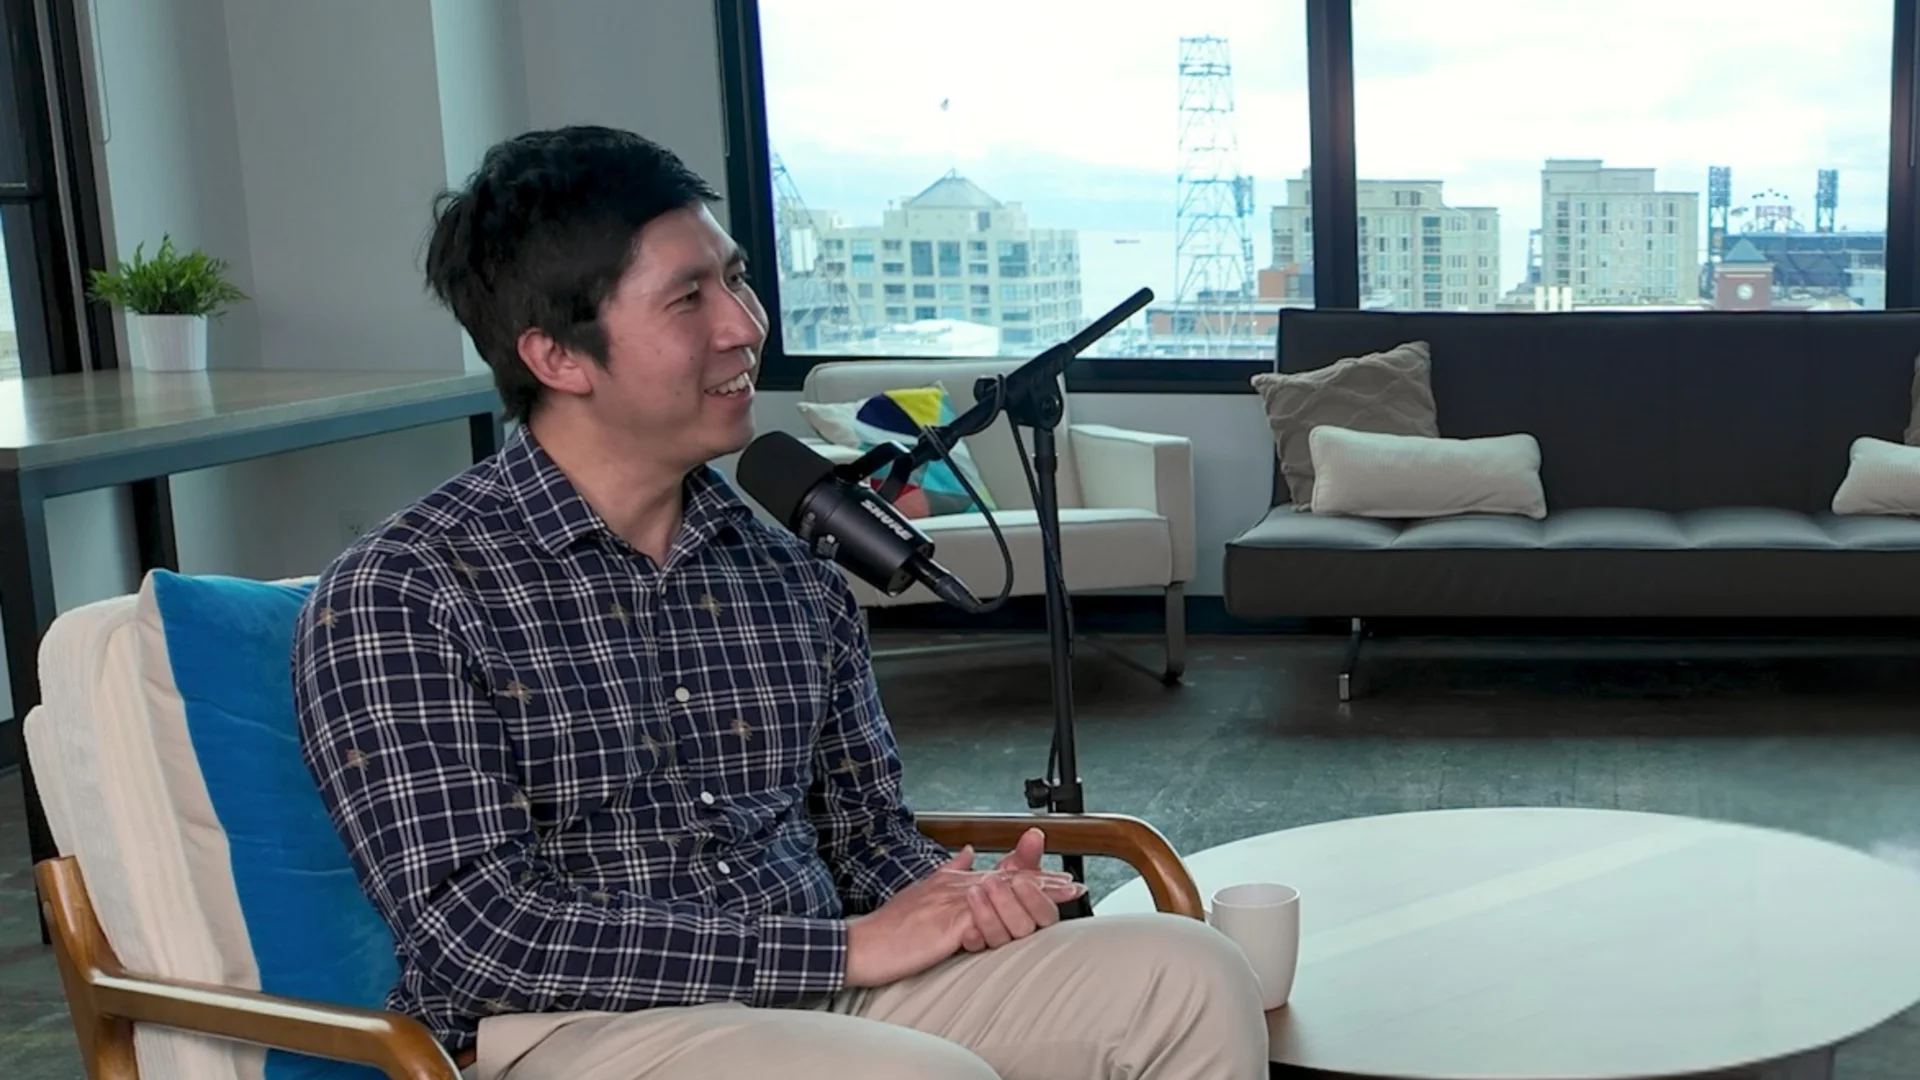
Elorian首席执行官Andrew Dai曾是谷歌DeepMind的研究员。他讲过一个具体的场景:去年一次游戏夜,他拍下和朋友刚玩完的桌游,问一个前沿模型谁赢了,模型答不出来。
他说,桌游“各有各的视觉语言,各自的图标、符号”,成年人几乎不需要文字就能看懂局势,模型却无法凭直觉判断这些符号的含义。他还举了宜家说明书的例子——人能照着没有文字的图示把家具装起来,AI为什么不行?
这个提问指向多模态模型的一处结构性短板。一次性的图像编码会丢掉大量细节,遇到密集文字、复杂图表、连续视频这类高信息密度素材,误差被迅速放大。把再确认一遍的动作交还给模型,是针对性补丁。
家里那个落地书架是照着说明书一格一格拼起来的。图是黑白线条,孔位标得模模糊糊,第几步该用哪颗螺丝全靠猜,装反了只能整段拆掉重来,指尖压在螺丝刀柄上硌出红印,半天直不起腰。那会儿就盼着有谁能把图上那句话讲明白。如今看到模型在宜家图示前也犯难,倒不觉得意外——连人都要反复比对的东西,机器想一次看懂,本来就难。再等一等吧,哪天拍张说明书过去,它真能一步步说清楚该拧哪颗螺丝,那才叫看懂了。
按Elorian的说法,一个不大的团队用几百块GPU训练出了Glimpse,模型规模明显小于它对标的前沿系统。这个叙事本身就有指向:在算力吃紧、成本高企的当下,小而专的路线是否有机会跑赢大而全。
定价为每百万token输入0.60美元、输出3美元。这个价位比Sonnet、Sol这类中端模型便宜,比Haiku、Luna这类轻量模型贵,卡在中间。
Elorian公布的评测称,Glimpse在科学图表推理和短视频描述上超过GPT-6 Astra,在其他视觉推理任务上也有竞争力。这些对比数据来自公司自己的评测,独立第三方复现尚未出现,研究预览阶段的项目大多如此。
融资方面,Elorian六个月前结束隐身状态,种子轮由Striker Venture Partners、Menlo Ventures和Altimeter Capital联合领投,英伟达与谷歌首席科学家Jeff Dean参投。
初期客户瞄准手里攥着大量视频的公司:机器人企业、科学实验室、媒体和创意机构。它们的共同点是视频数据又多又贵,人工标注不现实,只能指望模型自己看懂。
更远的方向是从“看见”走到“行动”。Elorian想用场景模型来选择动作,包括直接控制机器人。Dai说,明年的目标是做出“世界上最好的视觉推理模型”,在每一项视觉推理测试上都拿到第一。
这个目标喊得不小。视觉推理目前还没有公认的权威榜单,各家用的测试集和评分口径并不统一,所谓每项测试都领先,更大的意义在于表明方向,而非已经落地的既成事实。
对一家成立不久、产品刚露面的公司来说,先在机器人、实验室这类愿意为垂直能力付费的场景里站稳,可能比抢一个通用名号更实际。视觉推理这条赛道刚刚开了个头,谁能把“看准”变成“做对”,还要看接下来一两年的落地成绩。
 手机网游
 手游单机