OpenAI将在欧盟为ChatGPT文本添加隐形水印
OpenAI 宣布,将在欧盟为 ChatGPT 与 Codex 生成的文本加入隐形水印,以符合欧盟《人工智能法案》的透明度条款。
这项功能将在未来数周内推送给欧盟所有套餐的合格用户。面向开发者的 API 从即日起可为部分模型开启水印,默认关闭,公司暂时不打算把它变成全球默认选项。
欧盟人工智能法案的透明度规则已于8月2日生效,要求人工智能企业以其他系统能够识别的方式标注生成内容。在欧盟提供服务的模型厂商,都要在这套规则下拿出可被检验的方案。
这套ChatGPT文本水印并非肉眼可见的符号。它通过微妙地塑造模型的选词倾向,把一串读者察觉不到、检测器却能读出的规律埋进文字。文字被复制粘贴到别处,水印也随之迁移。
OpenAI 同步公布了名为 textGrain 的技术报告,由公司研究人员与宾夕法尼亚大学、耶鲁大学的学者合作完成。
报告给出了一种做法:用一把密钥对模型的下一个词预测排序。这样的微调叠加成百上千次,检测方仅凭文本和密钥,就能判断内容是否出自模型。
OpenAI 表示,水印不会识别用户身份,开启后模型表现也没有明显变化。公司同时提醒,检测不到水印并不能证明内容出自人手。
文本可能太短、被改动太多,也可能来自其他厂商的模型。水印只能说明某个模型生成或处理过其中一部分,无法衡量人类在里面的编辑与创造占了多少。
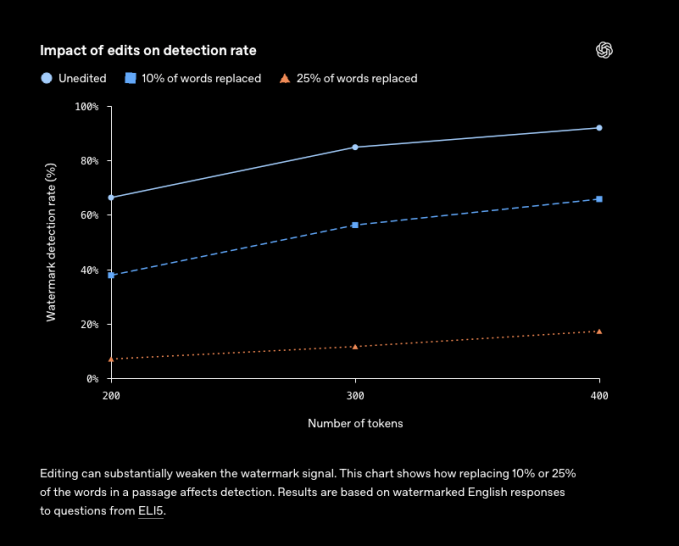
水印也能被编辑削弱。OpenAI 的测试显示,把一成词语换成同义词,检测率就从约92%降到66%。短句、数学答案和译文更难被识别。
检测器最初只向经过审核的研究者和专业机构开放,OpenAI 希望借他们评估可靠性与合理用法。
两个月前,Anthropic 宣布为 Claude 生成的文本加上水印,且在全球推行。这一决定在部分 Claude 用户中招致不满,他们的理由是:指令、背景和取舍都由自己完成,模型只是工具。
《华尔街日报》2024年曾报道,OpenAI 更早就做出过文本水印,却迟迟未上线,顾虑之一是用户会转向不打水印的竞争对手。如今水印只在欧盟落地,API 也保持默认关闭。
把水印锁在欧盟,等于把合规义务留在监管最严的市场,把体验风险留给别处。对一家全球用户数以亿计的公司来说,这是法律上的最小动作,也是商业上的试探。
如果欧盟用户的抱怨不强烈,水印有机会走向更多地区;如果反弹明显,欧盟就成了那个可以单独隔开的市场。
Anthropic、谷歌、Meta、微软与 OpenAI 都已承诺遵守欧盟关于人工智能生成内容的实践准则。承诺相同,落地方式却已经分叉。
大一那年,宿舍桌上那台旧笔记本,聊天窗口还是网页版,问一句答一句,当个新鲜玩意儿就关掉了。真正把它当工具用是后来赶材料的日子,半夜对着屏幕让模型先写个初稿,再一个词一个词地替换,把“显著”改成“明显”,把“因此”改成“所以”,自以为聪明地躲过了查重。如今看到一成词语替换就能让检测率从九成掉到六成多,那点侥幸又被翻了出来——要是当年下手再狠一点,检测器会不会也认不出来?可转念一想,人写下的字,本来也不必躲谁。
水印的意义,不在于让机器写的字彻底可查,而在于给内容生态留下一层可验证的痕迹。
它的上限由检测精度决定,下限由厂商的推广意愿决定。眼下这两条线都不算高。
 手机网游

 手游单机